Cramers v fachlich verstehen und anwenden
Cramers v verständlich erklärt. Grundlagen, Anwendung und häufige Fehler stehen im Überblick.
Cramers v
Um Cramers v fachlich zu verstehen, betrachten wir es als Maß für die Stärke eines Zusammenhangs in einer Kontingenztabelle. Wer die Kennzahl korrekt anwendet, erkennt, dass sie die Chi-Quadrat-Teststatistik auf einen Wert zwischen 0 und 1 skaliert und bei gleichbleibenden relativen Tabellenwerten von der Stichprobengröße unabhängig bleibt.
Einordnung: Assoziationsstärke in Kontingenztabellen
Cramers v ist ein Koeffizient, der die Stärke einer Assoziation in einer Kontingenztabelle als leichter einzuordnendes Maß ausdrückt. Um ihn korrekt anwenden zu können, musst du wissen, dass er die Chi-Quadrat-Teststatistik T, den gesamten Stichprobenumfang N und q zueinander in Beziehung setzt. Dabei bezeichnet q die kleinere der beiden Zahlen für Tabellenzeilen und Tabellenspalten.
Die Berechnung ergibt einen Wert von 0 bis 1. Nach der Quelle entspricht 0 dem Fehlen einer Assoziation; 1 bezeichnet die maximale Assoziation im Rahmen dieser Skalierung. Damit wird die Chi-Quadrat-Teststatistik auf diesen Wertebereich bezogen.
Für eine wissenschaftliche Arbeit kann die Einordnung an der vorhandenen Tabelle geprüft werden: Ermittle T, N und q, setze die Größen in die Formel ein und halte fest, dass der berechnete Koeffizient die Assoziationsstärke auf der beschriebenen Skala wiedergibt. Aussagen, die darüber hinausgehen, sollten erst nach einer passenden Quelle ergänzt werden.
Die Quelle beschreibt außerdem Skaleninvarianz: Eine Vergrößerung des Stichprobenumfangs verändert Cramers v nicht, wenn sich die Tabellenwerte im selben Verhältnis verändern. Bei der Darstellung kann daher geprüft werden, ob diese Bedingung für die betrachtete Veränderung der Tabelle erfüllt ist.
Halte die Überprüfbarkeit fest, indem du die Matrixstruktur, T, N, q und den zulässigen Wertebereich der Kennzahl ausdrücklich getrennt benennst.
Aufbau: Formelgrößen und Datenformen
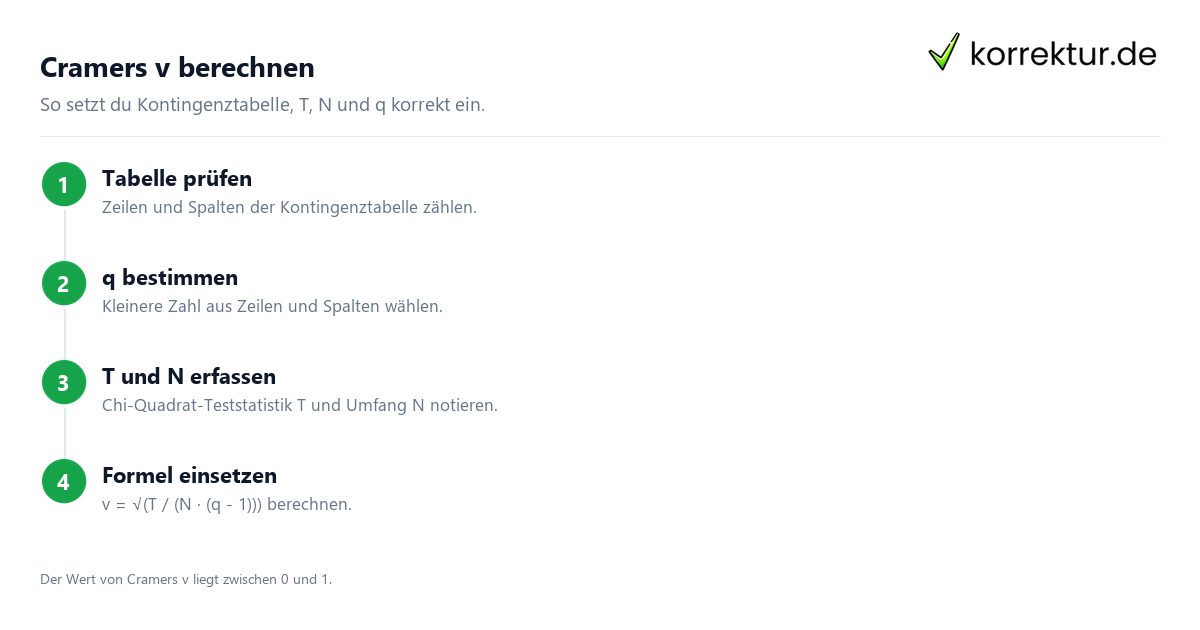
Für den Aufbau von Cramers v legt man zunächst die relevanten Größen der Gleichung fest. T steht für die Chi-Quadrat-Teststatistik. N bezeichnet den gesamten Stichprobenumfang. q ist die kleinere Zahl aus der Anzahl der Zeilen und der Anzahl der Spalten der Kontingenztabelle.
Mit diesen Größen lautet die Gleichung: Cramers v = sqrt(T / (N (q - 1))). Dabei wird die Chi-Quadrat-Teststatistik zu N und q ins Verhältnis gesetzt, und es ergibt sich ein Wert zwischen 0 und 1. Dabei steht 0 für keine Assoziation und 1 für die maximal mögliche Assoziation.
An der Tabelle lässt sich die Abfolge überprüfen: Zunächst zählt man die Zeilen- und Spaltengröße, leitet q davon ab, bestimmt dann T und N und prüft schließlich deren Verwendung in der Formel. So erkennt man klar, woher jede Größe stammt.
Die Daten für die Kontingenztabelle können nach der Quelle als Rohdaten oder als Tabellendaten vorliegen. Bei Rohdaten gibt es zwei Variablen: Die erste hat r unterschiedliche Werte, die zweite c unterschiedliche Werte. Daraus wird eine Kreuztabellierung mit den Zellhäufigkeiten erzeugt. Bei Tabellendaten liegen die Häufigkeiten der einzelnen Zellen bereits als Kontingenztabelle vor.
Für Tabellendaten sollen die Zellwerte nichtnegative ganze Zahlen sein, da sie Zählwerte der Zellen darstellen. Die unterschiedlichen Werte in Rohdaten müssen dagegen keine ganzen Zahlen sein. Prüfe deshalb vor der Berechnung, ob zwei Variablen erst kreuztabelliert werden müssen oder ob die Zähltabelle bereits vorliegt.
Teil des theoretischen Rahmens ist die formale Festlegung statistischer Unabhängigkeit. Für jede Kombination aus Zeile i und Spalte j gilt: P(Zeile i, Spalte j) = P(Zeile i) * P(Spalte j). Als konventionelle Prüfgröße zur Bestimmung dieser Unabhängigkeit nennt die Quelle die Chi-Quadrat-Teststatistik.
Vorgehen: Von der Tabelle zum Koeffizienten
- Basisdaten klären. Prüfe, ob zwei Merkmale als Rohdaten oder bereits als Häufigkeiten einer Kontingenztabelle vorliegen. Dies liefert eine eindeutig festgelegte Ausgangsform.
- Matrix strukturieren. Rohdaten werden zu einer Kreuztabelle mit Zellhäufigkeiten zusammengeführt. Vorhandene Zähltabellen übernimmt man direkt. Das Ergebnis ist eine Tabelle mit benannten Zeilen, Spalten und Zellwerten.
- Unabhängigkeitslogik notieren. Dokumentiere, dass die Quelle Unabhängigkeit über die Verknüpfung gemeinsamer und marginaler Wahrscheinlichkeiten definiert. Dies schafft eine klare begriffliche Grundlage für die Chi-Quadrat-Statistik.
- Prüfwert identifizieren. Nutze die bekannte oder berechnete Chi-Quadrat-Teststatistik und bezeichne sie als T. Dies ist der Wert im Zähler der Gleichung.
- Fallsumme zählen. Zähle alle Beobachtungen und bezeichne ihre Gesamtzahl mit N. Dies dient als Normalisierungsgröße im Nenner.
- Tabellendimensionen vergleichen. Bestimme die Anzahl der Zeilen und Spalten. q entspricht der kleineren dieser beiden Dimensionen. Dies liefert den zweiten Nenneranteil q: 1.
- Formel einsetzen. Trage T, N und q in
sqrt(T / (N (q - 1)))ein. Hierdurch entsteht der gesuchte Cramers-v-Wert. - Wert einordnen. Überprüfe, ob der berechnete Wert im vom Quellmaterial definierten Intervall zwischen 0 und 1 liegt. Dies führt zu einer begrenzten Interpretation: 0 bedeutet keinen Zusammenhang, 1 den maximal möglichen Zusammenhang.
- Darstellung prüfen. Dokumentiere die gewählte Datenstruktur, die Tabellenausmaße und die drei relevanten Parameter. So entsteht eine transparente Übersicht, anhand derer Dritte die Rechenlogik validieren können.
Durch diese Gliederung lassen sich Erfassung, Berechnung und Interpretation sauber voneinander trennen. Zudem vermeidet man Verwechslungen zwischen der kleineren Tabellendimension und der Summe aller Fälle. In wissenschaftlichen Texten schafft dies Klarheit, da jeder Parameter eine eindeutige Rolle in der Gleichung spielt.
Beispiel: Eine kurze Anwendung anhand einer Kreuztabelle
Für die kurze Beispielrechnung liegt eine Kontingenztabelle mit zwei Zeilen und drei Spalten vor. Die Einträge sind Häufigkeiten. Gegeben sind die Chi-Quadrat-Teststatistik T = 18 sowie die Gesamtzahl der Beobachtungen N = 90.
Im ersten Schritt leitet man q aus den Tabellendimensionen ab. Da zwei kleiner ist als drei, setzt man q = 2 an.
Nun werden die Werte in die Formel eingesetzt: sqrt(T / (N (q - 1))). Damit ergibt sich sqrt(18 / (90 (2 - 1))). Der Nenner ist 90, weil 2 - 1 = 1 ist. Es folgt sqrt(18 / 90), also sqrt(0,2). Das Ergebnis beträgt gerundet 0,447.
Die Rechnung kann deshalb so festgehalten werden: Für diese Tabelle ergibt sich ein Cramers-v-Wert von etwa 0,447. Der Wert entsteht aus der gegebenen Teststatistik, der gesamten Beobachtungszahl und der kleineren der beiden Tabellendimensionen.
In eigenen Darstellungen können die Schritte in derselben Reihenfolge dokumentiert werden: zuerst die Zeilen- und Spaltenzahl nennen, dann q bestimmen, anschließend T und N einsetzen und zuletzt den berechneten Wert angeben. So bleibt nachvollziehbar, welche Größen in die Formel eingegangen sind.
Das Beispiel verwendet lediglich angenommene Zahlen zur Veranschaulichung der Rechnung. Zusätzliche Deutungen des Ergebnisses sollten nur aufgenommen werden, wenn die verwendeten Angaben diese Deutung unmittelbar tragen.

Qualitätscheck zum Inhalt, zur Abgrenzung und zur Form prüfen
Der Qualitätscheck beginnt mit der Definition. Ist Cramers v ausdrücklich als Maß für die Stärke eines Zusammenhangs in einer Kontingenztabelle bezeichnet? Wird erklärt, dass die Kennzahl die Chi-Quadrat-Teststatistik auf einen Wert zwischen 0 und 1 skaliert? Sind 0 als kein Zusammenhang und 1 als maximaler Zusammenhang eingeordnet? Wenn eine dieser Aussagen fehlt, ergänze sie nur auf Grundlage der belegten Definition.
Danach werden die zentralen Merkmale geprüft. Sind T als Chi-Quadrat-Teststatistik, N als Gesamtzahl der Beobachtungen und q als kleinere Zahl aus Zeilen- und Spaltenanzahl erklärt? Steht die Formel in derselben Bedeutungszuordnung? Ist die Skaleninvarianz korrekt als Eigenschaft beschrieben, bei der sich der Koeffizient bei proportional veränderten Tabellenwerten und wachsender Stichprobengröße nicht verändert?
Getrennt davon prüft man die Praxisnähe. Lässt sich unterscheiden, ob rohe Messwerte oder aggregierte Tabellen vorliegen? Erklärt man bei Rohmesswerten den Aufbau der Kreuzmatrix aus zwei Merkmalen? Nutzt man bei tabellarischen Daten die Zellfrequenzen als Basis? Verbindet man jeden Rechenvorgang mit einem klaren Output, sei es Matrix, Parameter oder Faktor?
Abgrenzung: Prüfe, ob der Text Cramers v nicht mit der gesamten Chi-Quadrat-Teststatistik gleichsetzt. Die Chi-Quadrat-Statistik ist die Grundlage, Cramers v ist das daraus skalierte Maß. Markiere jede Aussage, die über diese Einordnung hinausgeht, und streiche sie, sofern die vorliegenden Angaben sie nicht unmittelbar tragen.
Formale Prüfung: Prüfe, ob die verwendete Tabelle, die Anzahl ihrer Zeilen und Spalten sowie die Bezeichnungen T, N und q sichtbar dokumentiert sind. Kontrolliere anschließend die Formel, die eingesetzten Werte und den Wertebereich zwischen 0 und 1. Prüfe zuletzt, ob die Schlussformulierung auf den Zusammenhang und seine Stärke beschränkt bleibt. Damit bleiben Definition, Merkmale, Anwendung und Abgrenzung getrennt erkennbar.
Empfohlene Passende nächste Schritte
Quellen und Stand
- Fachquelle: www.itl.nist.gov (zuletzt geprüft am 2026-08-15)