Den Chi-Quadrat-Test verstehen
Der Test für kategoriale Zusammenhänge
Der Chi-Quadrat-Test prüft anhand kategorialer Daten, ob die beobachteten Häufigkeiten mit der Annahme unabhängiger Merkmale vereinbar sind. Diese leicht verständliche Erklärung begleitet dich von der Kreuztabelle über die beobachteten und erwarteten Häufigkeiten bis hin zur Signifikanz, den nötigen Voraussetzungen und der richtigen Deutung des Ergebnisses.
Kostenlos herunterladen
Statistik berichten: Mustersätze für den Ergebnisteil
Ergebnisblätter nach APA 7 zum Ausfüllen: deskriptive Statistik, t-Test, Korrelation, Regression, Varianzanalyse und Chi-Quadrat-Test, jeweils mit Mustersatz, Tabelle und Effektstärke. Dazu die Schreibregeln für p-Werte, Symbole und Freiheitsgrade.
Wann der Chi-Quadrat-Test sinnvoll ist
Der Chi-Quadrat-Test (χ²-Test) beantwortet eine klar umrissene Frage: Besteht zwischen zwei nominalen oder ordinalen Merkmalen ein statistischer Zusammenhang? Ein typisches Beispiel ist die Verbindung zwischen Geschlecht und Studienwahl. Beide Variablen teilen Fälle in Kategorien ein. Deshalb werden keine Mittelwerte verglichen. Entscheidend ist vielmehr, wie häufig die Kombinationen der Kategorien in den Daten vorkommen. Wer den Chi-Quadrat-Test verstehen möchte, betrachtet dafür die tatsächlich beobachteten Häufigkeiten und stellt ihnen jene Häufigkeiten gegenüber, die bei Unabhängigkeit zu erwarten wären. Genau darum geht es bei der Aufgabe „Chi-Quadrat-Test: Zusammenhänge prüfen“.
Wie beobachtete und erwartete Häufigkeiten miteinander verglichen werden
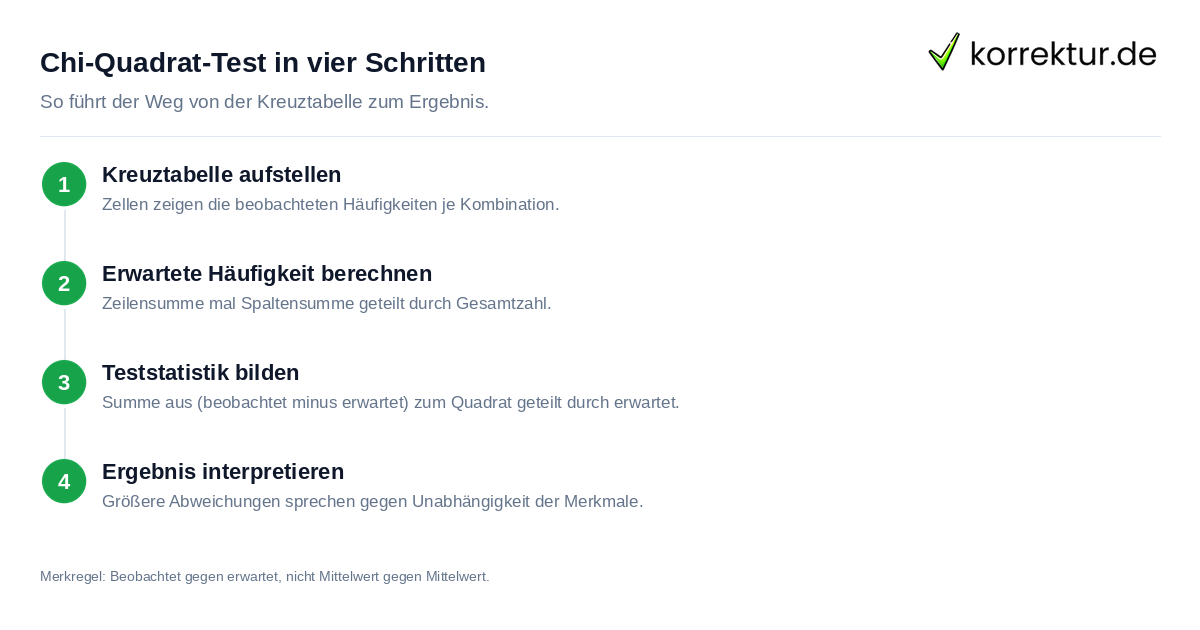
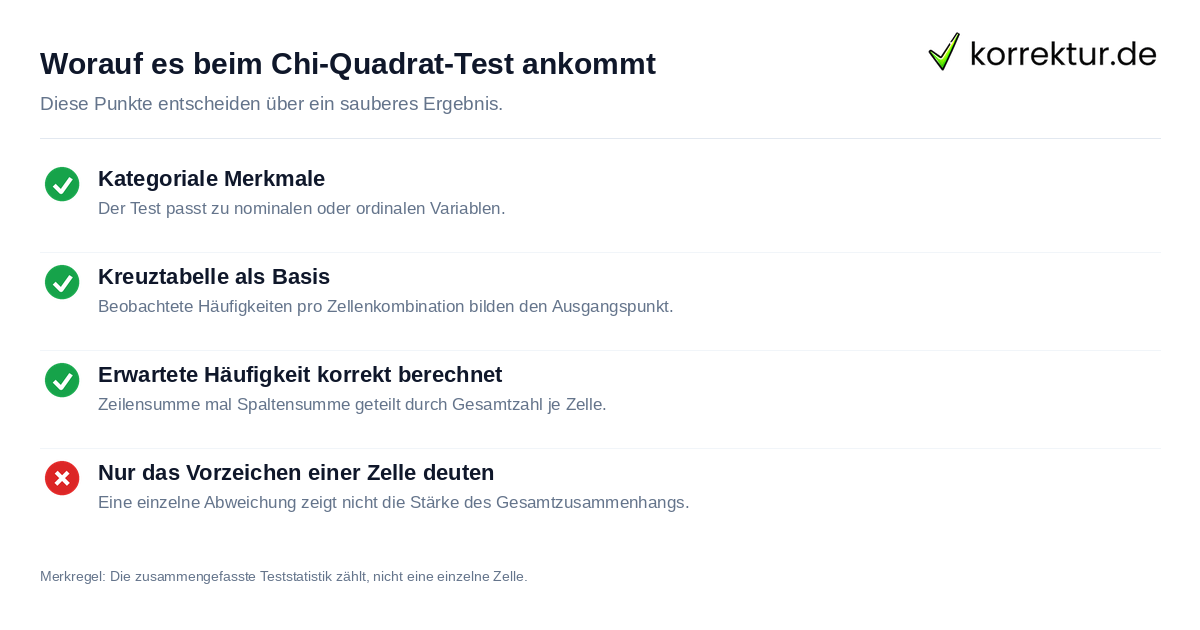
Grundlage jeder Rechnung ist eine Kreuztabelle. In ihren Zellen stehen die Anzahlen der Fälle, die jeweils zu einer bestimmten Kombination aus Zeilen- und Spaltenkategorie gehören. Diese Werte nennen wir beobachtete Häufigkeiten. Für jede Zelle ermittelt man anschließend die erwartete Häufigkeit = (Zeilensumme · Spaltensumme) / Gesamtzahl. Dieser Wert zeigt, wie die Daten verteilt wären, wenn die Merkmale voneinander unabhängig wären. Die Prüfgröße ergibt sich aus χ² = Summe aller Zellen von (beobachtet minus erwartet)² / erwartet. Damit berücksichtigt die Metrik jede Abweichung zwischen Beobachtung und Erwartung. Je größer diese Abweichungen insgesamt sind, desto größer wird χ² und desto stärker sprechen die Daten gegen Unabhängigkeit. Das Vorzeichen einer einzelnen Differenz zeigt hingegen nicht die Stärke des gesamten Zusammenhangs; maßgeblich ist die zusammengefasste Teststatistik.
Ergebnis anhand von p-Wert und Freiheitsgraden interpretieren
Ein χ²-Wert ist nicht isoliert zu beurteilen. Bei einer Kreuztabelle richten sich seine Einordnung und der p-Wert nach den Freiheitsgraden df = (Zeilen minus 1) · (Spalten minus 1) sowie nach dem vorab gewählten Signifikanzniveau. Die Freiheitsgrade ergeben sich aus der Zahl der Zeilen und Spalten der Kreuztabelle. Ist der p-Wert kleiner als das gewählte Signifikanzniveau, spricht das Ergebnis gegen die Annahme, dass beide Merkmale unabhängig sind. Signifikanz allein sagt jedoch noch nicht, wie stark der Zusammenhang ausfällt. Dafür kann ergänzend Cramérs V berichtet werden. Eine saubere Interpretation trennt deshalb die Frage, ob die Daten gegen Unabhängigkeit sprechen, von der Frage nach der Stärke des Zusammenhangs.
Voraussetzungen, die vor der Auswertung gelten
Vor der Interpretation müssen die Voraussetzungen geprüft werden. Der Test setzt unabhängige Beobachtungen voraus. Ein Fall darf die Zuordnung eines anderen Falls also nicht bestimmen. Für die asymptotische χ²-Approximation müssen die erwarteten Häufigkeiten ausreichend groß sein. In der Regel orientiert man sich an einer häufig verwendeten Richtlinie: Mindestens 80 % der erwarteten Werte sollten mindestens 5 betragen, und keine erwartete Häufigkeit sollte unter 1 liegen. Diese Prüfung bezieht sich auf die berechneten Erwartungswerte in den Zellen, nicht bloß auf den gesamten Stichprobenumfang. Falls diese Richtlinie nicht erfüllt ist, sollte je nach Tabellenform und Fragestellung ein exaktes oder simulationsbasiertes Verfahren geprüft werden; bei Vierfeldertafeln kann der exakte Test nach Fisher eine Option sein. Die Wahl des Verfahrens sollte daher erfolgen, bevor der p-Wert inhaltlich gedeutet wird.
Typische Fehler bei Berechnung und Interpretation vermeiden
Mehrere Fehler können das Ergebnis unbrauchbar oder missverständlich machen. Dazu zählt, den Chi-Quadrat-Test trotz zu kleiner erwarteter Häufigkeiten einzusetzen, ohne die Eignung der Approximation zu prüfen. Ebenso falsch ist es, aus einem signifikanten Ergebnis automatisch auf eine starke Beziehung zu schließen, denn Signifikanz ≠ Effektstärke. Für die Kreuztabelle werden absolute Häufigkeiten benötigt; Prozentwerte allein ersetzen sie nicht. Auch die Schlussfolgerung sollte präzise bleiben: Ein signifikantes Ergebnis spricht gegen die Annahme der Unabhängigkeit, erklärt aber nicht die Ursache eines Zusammenhangs. In SPSS findest du das Verfahren unter „Kreuztabellen“. Dort sollten vor dem Berichten sowohl die Zellen als auch die Testausgabe kontrolliert werden. Ein Lektorat kann die sprachliche und formale Berichtsweise unterstützen. So lässt sich der Chi-Quadrat-Test nachvollziehbar verstehen, korrekt anwenden und angemessen einordnen.
Für die Vorbereitung der Analyse hilft die Seite Skalenniveaus erklärt, weil die Auswahl des Tests zur Art der Variablen passen muss. Das Thema Konfidenzintervall berechnen ergänzt das Verständnis statistischer Schätzungen. Einen breiteren Einstieg in die Beschreibung von Daten bietet die deskriptive Statistik; weitere Verfahren und Orientierung bündelt der Statistik- und SPSS-Hub. Vor der Abgabe kann Korrekturlesen helfen, die sprachliche Darstellung von Ergebnissen, Tabellen und Formulierungen zu prüfen.