Korrekturprogramme im Blindtest: 67 versteckte Fehler
Was automatische Korrektur findet und wo sie geschlossen ausfällt
Für diesen Korrekturprogramme-Blindtest haben wir fünf sprachlich einwandfreie Texte geschrieben und darin anschließend 67 genau definierte Fehler versteckt: jeder mit festgelegter Position, Kategorie und korrekter Lösung. Erst danach haben die Werkzeuge die Texte gesehen, ohne Hinweis auf Anzahl oder Art der Fehler. Das Ergebnis fällt eindeutiger aus als erwartet, und zwar in beide Richtungen.
Der Aufbau: erst der saubere Text, dann der Fehler
Die übliche Schwäche solcher Tests ist der Maßstab. Wer einen fehlerhaften Text durch mehrere Korrekturprogramme schickt und die Meldungen zählt, weiß nie, wie viele Fehler tatsächlich drinsteckten. Wir haben deshalb umgekehrt gearbeitet: Zuerst entstanden fünf fehlerfreie Texte aus unterschiedlichen Textsorten, danach wurde jeder einzelne Fehler bewusst eingesetzt.
Somit ist der Bewertungsrahmen klar vorgegeben. Für jeden Mangel notierten wir Ort, Typ und die passende Lösung. Ein Programm gilt als erfolgreich, wenn sein Hinweis die hinterlegte Fehlerstelle trifft. Jeder Alarm, der auf keine dieser Stellen zeigt, zählt als Fehlalarm.
Unsere Sammlung umfasst fünf Texte mit 7.815 Zeichen und 67 versteckten Fehlern in acht Gruppen. Die Mischung ist gewollt, denn Korrekturprogramme reagieren auf wissenschaftliche Schriften anders als auf Romane: ein Methodenkapitel einer Bachelorarbeit, ein Bewerbungsschreiben, ein Romanbeginn, ein Berichtsausschnitt und eine Ratgeberpassage.
Was geprüft wurde
Drei Zugänge standen im Test, alle in ihrer kostenlos zugänglichen Form:
- LanguageTool über die freie Schnittstelle, also ohne Konto und ohne Bezahltarif
- Sprachmodell im Meldemodus: ein aktuelles GPT-5.6-Modell in mittlerer Leistungsstufe, beauftragt, jeden Fehler zu benennen
- Sprachmodell im Korrekturmodus: dasselbe Modell, angewiesen, den Text zu korrigieren und alles Richtige unverändert zu lassen
Diese Untergliederung ist der interessanteste Teil des Aufbaus. Gleicher Algorithmus, gleicher Inhalt, nur der Auftrag unterscheidet sich. Wer davon ausgeht, dass das Ergebnis identisch wäre, irrt sich.

Das Gesamtergebnis
Keines der drei Korrekturprogramme findet alles. Zwischen dem schwächsten und dem stärksten Ergebnis liegen 27 Prozentpunkte.
| Werkzeug | Gefundene Fehler | Quote | Fehlalarme |
|---|---|---|---|
| LanguageTool (kostenlos) | 42 von 67 | 63 % | 7 |
| Sprachmodell, Meldemodus | 56 von 67 | 84 % | 1 |
| Sprachmodell, Korrekturmodus | 60 von 67 | 90 % | 0 |
Bemerkenswert ist die Spalte ganz rechts. LanguageTool meldet sieben Stellen, an denen gar kein Fehler war. Im Korrekturmodus hat das Sprachmodell dagegen keine einzige korrekte Stelle eigenmächtig verändert: kein Umformulieren, kein Stilbessern, keine gestrichenen Sätze. Genau das ist die Sorge, die viele beim Einsatz von KI-Korrektur haben, und sie hat sich in diesem Durchgang nicht bestätigt.
Nach Fehlerarten aufgeschlüsselt
Der Gesamtwert blendet aus, dass Korrekturprogramme sehr unterschiedliche Stärken haben. Die Gliederung in acht Bereiche zeigt, wo die Unterschiede tatsächlich liegen.
| Fehlerart | LanguageTool | KI, Meldemodus | KI, Korrekturmodus |
|---|---|---|---|
| Rechtschreibung | 18 von 18 | 14 von 18 | 17 von 18 |
| Zeichensetzung | 3 von 10 | 10 von 10 | 10 von 10 |
| Grammatik | 2 von 7 | 6 von 7 | 6 von 7 |
| Getrennt und zusammen | 7 von 9 | 8 von 9 | 9 von 9 |
| Groß und klein | 7 von 9 | 8 von 9 | 9 von 9 |
| Wortverwechslung | 3 von 5 | 5 von 5 | 5 von 5 |
| Typografie | 2 von 4 | 4 von 4 | 4 von 4 |
| Inhaltlicher Widerspruch | 0 von 5 | 1 von 5 | 0 von 5 |
Zwei Reihen fallen auf. In Sachen Rechtschreibung ist LanguageTool perfekt und schlägt beide KI-Durchläufe: 18 von 18, während das Modell im Meldemodus vier schlichte Buchstabendreher übersieht. Bei der Zeichensetzung kehrt sich das Bild um: 3 von 10 versus 10 von 10.
Das ist kein Zufall, sondern folgt aus der Bauweise. Ein regelbasiertes Werkzeug erkennt ein falsch geschriebenes Wort zuverlässig, weil es im Wörterbuch fehlt. Ob vor einem Nebensatz ein Komma stehen muss, ergibt sich dagegen aus dem Satzbau, und dort kommt ein Regelwerk schnell an seine Grenzen.
Die blinde Stelle, die allen gemeinsam ist
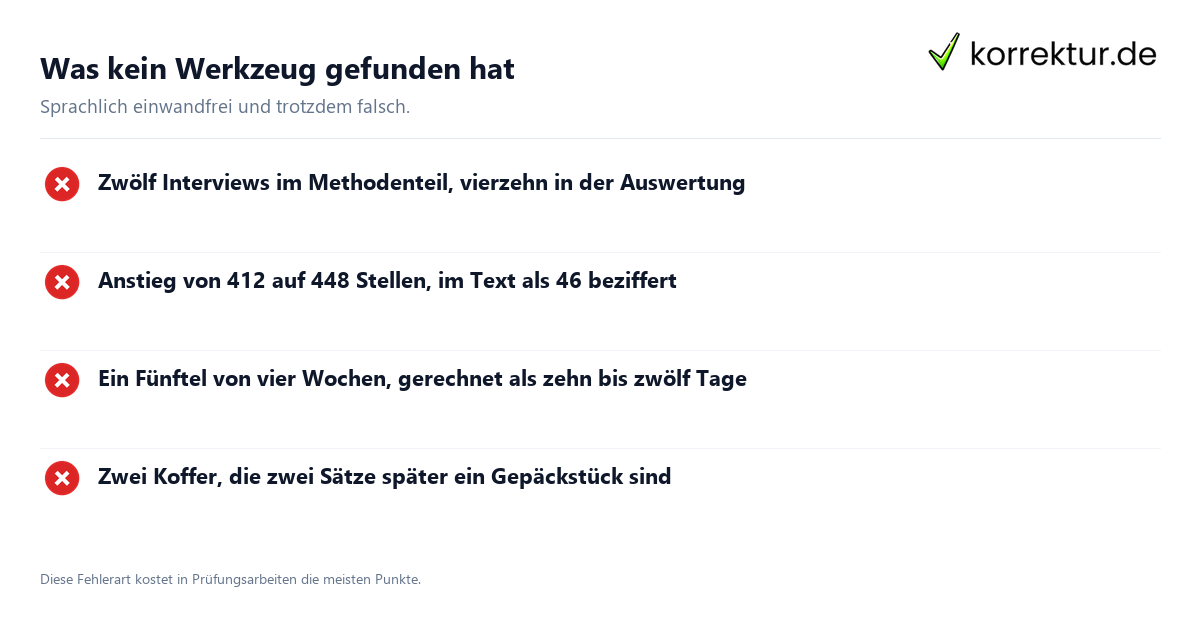
In der letzten Zeile der Tabelle steht das eigentliche Ergebnis dieser Studie. Fünf der 67 Fehler sind orthografisch vollkommen unauffällig: Jedes Wort ist richtig geschrieben, jeder Satz ist grammatisch korrekt. Falsch ist nur die Aussage. Von diesen fünf Fehlern findet LanguageTool null, das Sprachmodell im Korrekturmodus ebenfalls null, im Meldemodus genau einen.
Im Einzelnen waren das diese Stellen:
- zwölf Interviews nennt der erste Absatz des Methodenteils, doch im Schlussabsatz tauchen vierzehn auf.
- Im Geschäftsbericht steigen die Mitarbeitenden von 412 auf 448, anschließend spricht der Text vom Anstieg um 46 Stellen. Die tatsächliche Differenz beträgt 36.
- Der Ratgeber rät, ein Fünftel der Zeit für Recherche einzusetzen, und errechnet bei vier Wochen zehn bis zwölf Tage. Mathematisch sind das knapp sechs Tage.
- Bereits beim Einstieg hebt die Protagonistin die beiden Koffer vom Gepäckträger ab. Wenig später fasst ihre gesamte Habe in einem einzigen Paket Platz.
- Das Bewerbungsschreiben beruft sich auf Erfahrung aus einer Werkstudentenstelle, obwohl sich der Verfasser gerade erst um seine erste Stelle bewirbt.
Das sind die Fehler, die in einer Prüfungssituation wehtun. Eine falsch geschriebene Vokabel kostet Sympathie, eine Fallzahl, die sich zwischen Methodenteil und Auswertung ändert, kostet Punkte und wirft die Frage auf, ob die Daten überhaupt stimmen. Genau diese Klasse von Fehlern erkennt kein getestetes Werkzeug verlässlich, weil sie sich nur aus dem Verständnis des ganzen Textes ergibt.
Melden und korrigieren sind nicht dasselbe
Dasselbe Modell, derselbe Text, zwei Aufträge, zwei Ergebnisse: 56 gegen 60 Treffer. Aufschlussreich ist, wo die Differenz entsteht. Im Meldemodus übersieht das Modell vier einfache Rechtschreibfehler, die es im Korrekturmodus stillschweigend repariert.
Die plausible Erklärung: Wer eine Liste von Funden aufschreiben soll, priorisiert das Auffällige und Erklärungswürdige. Wer einen Text sauber ausgeben soll, bügelt Tippfehler nebenbei mit aus, ohne sie zu erwähnen. Für die Praxis heißt das: Eine KI-Fehlerliste ist nicht vollständig, auch wenn sie vollständig aussieht. Wer nur die gemeldeten Punkte abarbeitet, übernimmt die übersehenen Fehler ungeprüft in die Endfassung.
Umgekehrt hat der Korrekturmodus einen anderen Nachteil: Er liefert einen fertigen Text ohne Begründung. Was geändert wurde, muss man selbst herausfinden. Wer den Vergleich nicht macht, gibt am Ende einen Text ab, den er nicht mehr in allen Teilen kennt.
Was das für die Praxis bedeutet
Korrekturprogramme sind erheblich besser als ihr Ruf und erheblich schlechter als ihr Marketing. Die nüchterne Ableitung aus den Zahlen:
- Für die Rechtschreibung reicht ein kostenloses Werkzeug. 18 von 18 sind ein perfektes Ergebnis, dafür muss niemand zahlen.
- Auf Regeln beim Komma kannst du dich nicht verlassen. 3 von 10 bedeutet, dass sieben von zehn Kommafehlern stehen bleiben.
- Überprüfe Zahlen und Bezüge selbst. Fallzahlen, Summen, Verweise auf Kapitel und Abbildungen: Kein Werkzeug im Test hat hier etwas gefunden.
- Doppelprüfung schlägt Einzelscan. Die Stärken ergänzen sich: Regelwerke fangen die Rechtschreibung, Sprachmodelle die Zeichensetzung.
Wo beide Strategien enden, beginnt die Rolle zweiter Lesender: Inkonsistenzen zeigen sich nur, wenn jemand den kompletten Inhalt im Gedächtnis hält. In dieser Runde testeten wir ausschließlich Werkzeuge, keine menschliche Korrektur. Ob unsere Redaktion die 67 Fehler findet, bleibt hier unbewiesen. Dieser Gegencheck steht für die Folgearbeit mit gleicher Basis und Messlatte an.
Methodik und Nachprüfbarkeit
Für die Nachprüfbarkeit stehen hier die Randbedingungen vollständig:
- Korpus: fünf selbst verfasste Texte, 7.815 Zeichen, keine fremden Inhalte, keine Kundendokumente
- Fehler: 67 Einsetzungen mit festgelegter Position, Kategorie und Sollfassung, dokumentiert vor dem Test
- Treffer: die Meldung eines Werkzeugs überlappt die hinterlegte Fehlerstelle; alles andere zählt als Fehlalarm
- Stilhinweise zählen nicht: Geschmacksfragen werden weder als Treffer noch als Fehlalarm gewertet
- Durchführung: ein Durchlauf je Werkzeug, ohne Nachbesserung und ohne Auswahl des besten Ergebnisses
Die Grenzen sind ebenso klar: Fünf Texte sind eine kleine Stichprobe, und die Auswahl der Fehler ist unsere. Ein anderer Korpus mit anderem Schwerpunkt käme auf andere Prozentwerte. Was sich dadurch nicht ändert, ist das Muster, weil es aus der Funktionsweise der Werkzeuge folgt: Regelwerke sind stark bei Wörtern, Sprachmodelle bei Sätzen, und den Textzusammenhang prüft keines von beiden.
Vertiefende Informationen finden sich hier: Rechtschreibprüfungen im Vergleich, LanguageTool im Test, warum menschliches Lektorat bleibt sowie Korrekturlesen und Lektorat.