OCR-Scan, Dokument in lesbaren Text umwandeln
Lass eingescannte PDFs oder Foto-Dokumente mit OCR (Texterkennung) direkt in deinem Browser in lesbaren Text umwandeln, ohne dass eine Datei hochgeladen wird.
OCR-Scan starten
Starte nach Auswahl deines Dokuments den Vorgang. Kontrolliere die Ergebnisse bitte vor ihrer Weiterverarbeitung.
100 % lokal
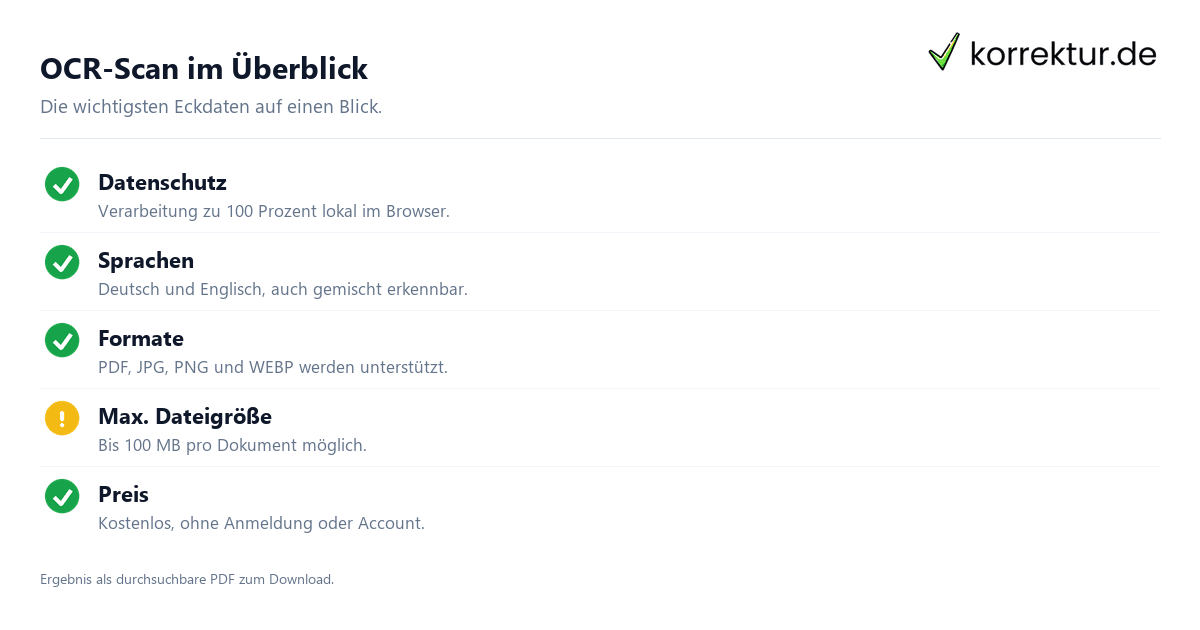
Deine Daten verbleiben im Browser; die Analyse findet vollständig auf deinem lokalen System statt.
PDF & Bilder
OCR kann Text aus gescannten PDFs und abfotografierten Vorlagen erkennen.
Sprachen Deutsch und Englisch
Tesseract stellt Sprachdaten für Deutsch und Englisch bereit. In Mischtexten kann manuelle Nachbearbeitung nötig sein.
Download als PDF
Du erhältst eine durchsuchbare PDF, benannt nach dem Muster ocrscan-korrektur-de-<dateiname>.pdf.
Wann ist ein OCR-Scan sinnvoll?
Ein OCR-Scan (Optical Character Recognition) wandelt Bildinhalte in maschinenlesbaren Text um. Er kann sinnvoll sein, wenn eine PDF nur aus Bildseiten besteht. Solche Dateien lassen sich häufig nicht durchsuchen oder von automatischen Seiten- oder Zeichenzählern auswerten.
Typische Fälle sind ein mit dem Handy fotografiertes Blatt, eine vom Scanner erzeugte PDF ohne Text-Ebene oder das Foto einer Tafel oder Buchseite. Du erhältst eine PDF mit erkanntem Text, den du etwa für das Korrekturlesen, das Lektorat, die Plagiatsprüfung oder die Normseiten-Berechnung verwenden kannst. Prüfe den erkannten Text zuvor auf Fehler.

So läuft der OCR-Scan ab
Als Basis dient die quelloffene OCR-Engine Tesseract, welche dank WebAssembly vollständig im Browser läuft. Deine PDF wird zunächst als Bild dargestellt, anschließend erkennt die Engine die Schriftzeichen, und schließlich entsteht eine neue PDF mit dem erkannten Text. Da sämtliche Prozesse lokal ablaufen, bleiben deine Daten dabei auf deinem eigenen Gerät.
Das Ergebnis bei deutschen, englischen oder gemischten Texten hängt unter anderem von Sprache, Bildauflösung und Layout ab. Auch die Dauer hängt von Seitenzahl und Gerät ab; bei umfangreichen Dokumenten kann sie entsprechend länger ausfallen.
Welche Dateiformate werden unterstützt?
Der Dienst verarbeitet aktuell PDF-Dateien sowie die Bildformate JPG, PNG und WEBP. Pro Datei sind bis zu 100 MB möglich. Word-Dokumente (DOCX), RTF- oder ODT-Dateien enthalten ihren Text ohnehin schon; hier genügt es meist, sie als PDF zu speichern und direkt weiterzugeben.