Stichprobe und Grundgesamtheit in der empirischen Forschung
Warum Stichprobe und Grundgesamtheit zusammengehören
Dieser Abschnitt erläutert, wie Stichprobe und Grundgesamtheit die Auswahl in der empirischen Forschung strukturieren.
Im nächsten Abschnitt folgt die Definition der zentralen Begriffe.
Präzise Begriffe abgrenzen
Die Grundgesamtheit, auch Population genannt, bezeichnet die Menge aller Einheiten mit einer gemeinsamen Eigenschaft, beispielsweise sämtliche Studierenden einer Hochschule. Die Stichprobe bildet eine Teilmenge dieser Einheiten, die tatsächlich befragt oder gemessen wird. Da eine Vollerhebung häufig zu aufwendig oder nicht durchführbar ist, wird von der Stichprobe auf die Grundgesamtheit geschlossen.
Man unterscheidet zusätzlich zwischen der angestrebten und der tatsächlich erreichbaren Grundgesamtheit. Fallen viele Elemente aus dem Auswahlrahmen heraus, entsteht ein Deckungsfehler. Eine saubere Definition beider Ebenen ist die Grundlage jeder späteren deskriptiven Statistik und jeder Verallgemeinerung deiner Befunde. Praktisch bedeutet das: Definierst du deine Grundgesamtheit zu weit, überschätzt du die Reichweite deiner Aussagen; fasst du sie zu eng, verschenkst du Erkenntnispotenzial. Formuliere deshalb genau, welche Personen, Objekte oder Zeiträume dazugehören und welche ausdrücklich nicht.
Verschiedene Auswahlverfahren im Überblick
Unterschieden wird zwischen zufälligen und nicht zufälligen Methoden. Beim ersten Typ verfügt jedes Element über eine bekannte Auswahlwahrscheinlichkeit, was statistische Ableitungen erlaubt:
- Einfache Zufallsstichprobe: Jedes Element hat die gleiche Chance, ausgewählt zu werden, beispielsweise mithilfe eines Zufallszahlengenerators.
- Geschichtete Stichprobe: Die Grundgesamtheit wird in Schichten wie Studiengänge geteilt, aus denen jeweils zufällig gezogen wird.
- Klumpenstichprobe: Ganze Gruppen, etwa Seminargruppen, werden zufällig ausgewählt. Ob anschließend alle oder nur ausgewählte Einheiten dieser Gruppen untersucht werden, hängt vom Stichprobendesign ab.
Nicht zufällige Verfahren wie Quoten- oder Gelegenheitsstichproben sind zwar leichter anzuwenden, erlauben aber ohne zusätzliche Annahmen keine designbasierte Verallgemeinerung auf die Grundgesamtheit.
Repräsentativität angemessen gewährleisten
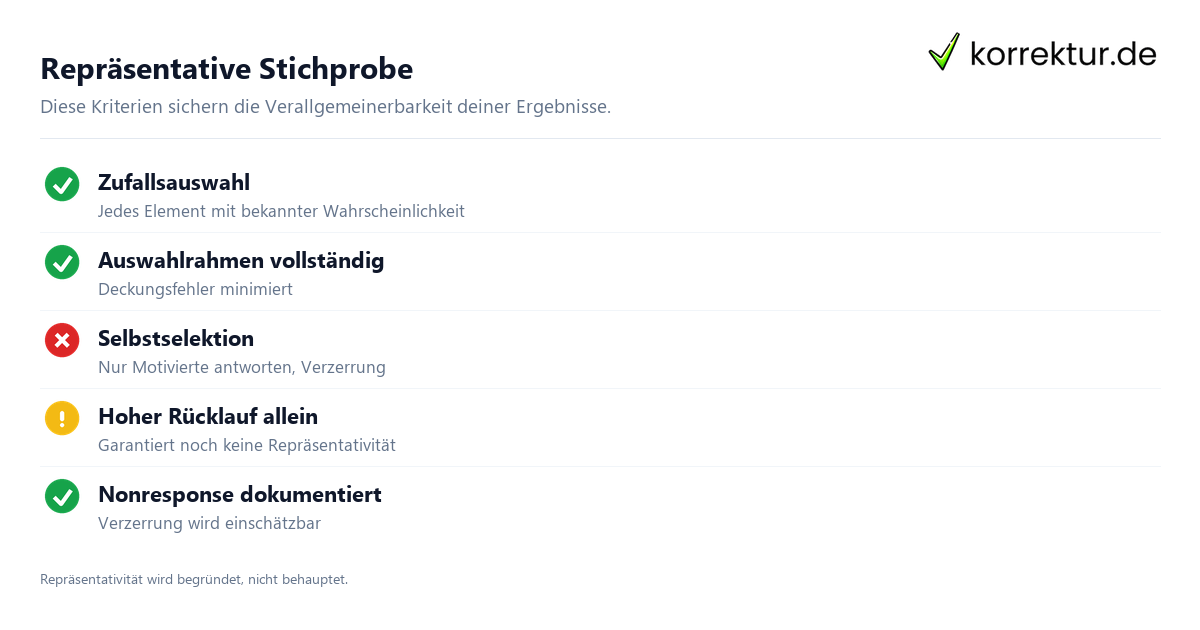
Eine Stichprobe kann als repräsentativ gelten, wenn sie für die jeweilige Fragestellung relevante Merkmale der Grundgesamtheit angemessen abbildet. Verzerrungen können beispielsweise durch Selbstselektion entstehen, wenn vor allem motivierte Personen antworten, oder durch einen unvollständigen Auswahlrahmen.
Repräsentativität lässt sich nicht einfach postulieren, sondern kann durch ein sorgfältiges Zufallsverfahren und den Abgleich mit bekannten Populationsmerkmalen begründet werden. Für die spätere Modellierung von Zusammenhängen zwischen Merkmalen, etwa mittels Regressionsanalyse, ist eine möglichst unverzerrte Datenbasis erforderlich. Ein hoher Rücklauf allein belegt keine Repräsentativität, wenn sich die Antwortenden systematisch von den Nichtantwortenden unterscheiden. Daher sollte idealerweise auch dokumentiert werden, wer nicht geantwortet hat, um mögliche Verzerrungen beurteilen zu können.
Stichprobengröße ermitteln und in SPSS ziehen
Der erforderliche Stichprobenumfang richtet sich nach dem angestrebten Konfidenzniveau, der akzeptierten Fehlermarge und der Merkmalsstreuung. Als Faustregel gilt: Je geringer der tolerierte Fehler und je höher das Konfidenzniveau, desto größer muss die Stichprobe ausfallen. Für eine Anteilsschätzung bei 95 Prozent Konfidenz und fünf Prozent Fehlermarge gelten rund 384 Fälle nur bei großer Grundgesamtheit, einfacher Zufallsstichprobe und der konservativen Annahme p = 0,5. Bei endlichen Populationen oder komplexen Stichprobendesigns muss der Bedarf angepasst werden.
Direktes Ziehen in SPSS funktioniert so:
- Öffne Daten → Fälle auswählen.
- Wähle Zufallsstichprobe von Fällen und klicke auf Stichprobe.
- Wähle entweder einen ungefähren Anteil in Prozent oder eine genaue Fallzahl. Bei der genauen Fallzahl gibst du zusätzlich an, aus wie vielen der ersten Fälle gezogen werden soll.
- Bestätige die Auswahl mit Weiter und OK; SPSS kennzeichnet die gezogenen Fälle in einer Filtervariablen.

Stichprobenfehler korrekt einordnen
Der Stichprobenfehler beschreibt zufallsbedingte Abweichungen zwischen einem Stichprobenkennwert und dem Parameter der Grundgesamtheit. Der Standardfehler beschreibt die Streuung eines Stichprobenkennwerts über gedachte Wiederholungsstichproben und nimmt bei sonst gleichen Bedingungen mit wachsender Stichprobengröße ab. Konfidenzintervalle machen die Unsicherheit einer Schätzung unter den jeweiligen Modellannahmen sichtbar.
Davon zu trennen sind systematische Fehler, die durch fehlerhafte Auswahl oder Messung entstehen und sich nicht allein durch größere Stichproben beheben lassen. Um die Unsicherheit einer Schätzung transparent zu machen, kannst du neben dem Schätzwert einen Standardfehler oder ein Konfidenzintervall berichten. Ein schmales Intervall weist unter denselben Annahmen auf höhere Präzision hin als ein breites; die inhaltliche Bedeutung des Effekts ergibt sich daraus jedoch nicht.
Methodik der Abschlussarbeit festhalten
Im Methodenteil beschreibst du die Grundgesamtheit, den Auswahlrahmen, das verwendete Auswahlverfahren, die angestrebte und die tatsächliche Stichprobengröße sowie die Ausschöpfungsquote. Diese Transparenz ermöglicht es Prüfenden, die Qualität der Daten und die Reichweite der Schlussfolgerungen einzuschätzen.
Eine nachvollziehbare Darstellung ermöglicht es, die Voraussetzungen und Grenzen eines Hypothesentests einzuschätzen. Ein abschließendes Korrekturlesen und Lektorat kann dazu beitragen, dass Fachbegriffe wie Auswahlrahmen und Stichprobenfehler konsistent und korrekt verwendet werden.
Zusätzliche Statistik-Grundlagen: Konfidenzintervall, Mann-Whitney-U-Test und Statistik und SPSS.
Hinweise zur Rekrutierung von Teilnehmenden findest du in den Beiträgen Umfrage-Teilnehmer finden sowie Probanden für Experimente finden.