KIDetektiv und ZeroGPT im Falschalarm-Test
Texte ohne KI-Ursprung und was die Detektoren daraus machen
Ein Vorwurf der KI-Nutzung ist schwer zu widerlegen, sobald ein KI-Detektor eine Arbeit als maschinell erzeugt einstuft. Daher zählt weniger, wie zuverlässig KI-Text erkannt wird, als vielmehr, wie häufig menschlich verfasste Texte fälschlich beanstandet werden. Aus diesem Grund haben wir KIDetektiv und ZeroGPT 30 Abschlussarbeiten aus den Jahren 2007 bis 2020 vorgelegt. Diese Texte wurden vor der Veröffentlichung von ChatGPT verfasst. Allein das Veröffentlichungsdatum belegt jedoch nicht für jede Passage die menschliche Urheberschaft.
Kostenlos herunterladen
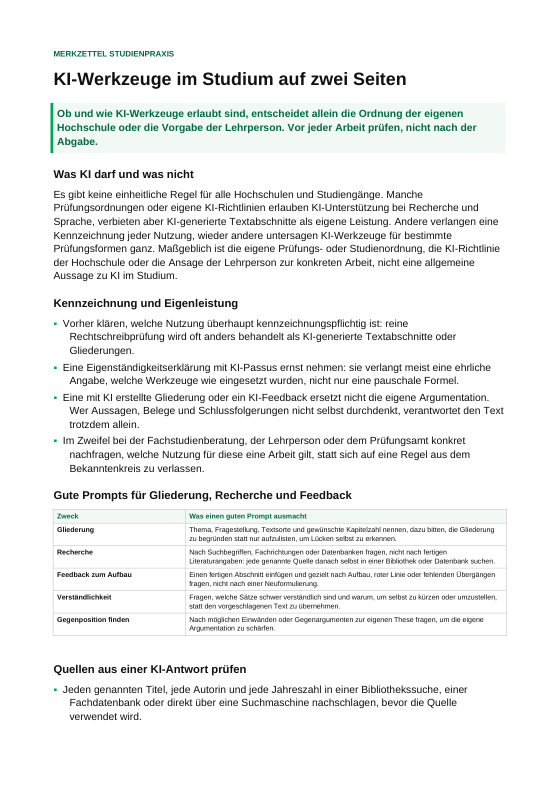
KI-Werkzeuge im Studium: Merkzettel für den richtigen Umgang
Die Grenze zwischen Hilfsmittel und Eigenleistung, gute Prompts für Gliederung, Recherche und Feedback, die Pflicht zur Quellenprüfung, KI beim Korrekturlesen, die Grenzen von Textdetektoren und Datenschutz mit fremden Texten. Erlaubnis und Kennzeichnung verweisen bewusst auf die eigene Hochschule.
Warum alte Abschlussarbeiten besonders geeignet sind
Bei Tests dieser Art ist die Beweislage oft das Hauptproblem. Bei selbst verfassten Texten lässt sich die eigene Urheberschaft zwar behaupten, aber nicht objektiv belegen. Eine Arbeit, die 2009 auf einem Hochschulserver veröffentlicht wurde, ist ein starkes Indiz für eine menschliche Entstehung; ohne Unterlagen zur Entstehung lässt sich die Urheberschaft einzelner Passagen jedoch nicht abschließend belegen.
Sofern die historischen Texte tatsächlich von Menschen stammen, stellt jede positive Anzeige eines Detektors einen Falschalarm dar. Dieser Anteil bildet die Falsch-Positiv-Rate, eine wesentliche Größe zur Einschätzung der Genauigkeit eines Systems.
Das Material enthält 30 Bachelor- und Masterarbeiten aus den Jahren 2007 bis 2020 zweier Hochschulen sowie 15 gezielt erzeugte KI-Texte. Die Abschnitte der Abschlussarbeiten umfassen etwa 1.600 Zeichen und stammen aus dem Hauptteil.
Das Ergebnis
Für den Test wurden KIDetektiv und ZeroGPT genutzt. Die Übersicht zeigt die Auswertung bei 50 und 25 Prozent; diese Schwellen dienen der Einordnung des Testkorpus und sind keine allgemein verbindlichen Grenzwerte.
| KIDetektiv | ZeroGPT | |
|---|---|---|
| Mittelwert bei Menschentext | 24,0 % | 2,5 % |
| höchster Wert bei Menschentext | 85,0 % | 40,4 % |
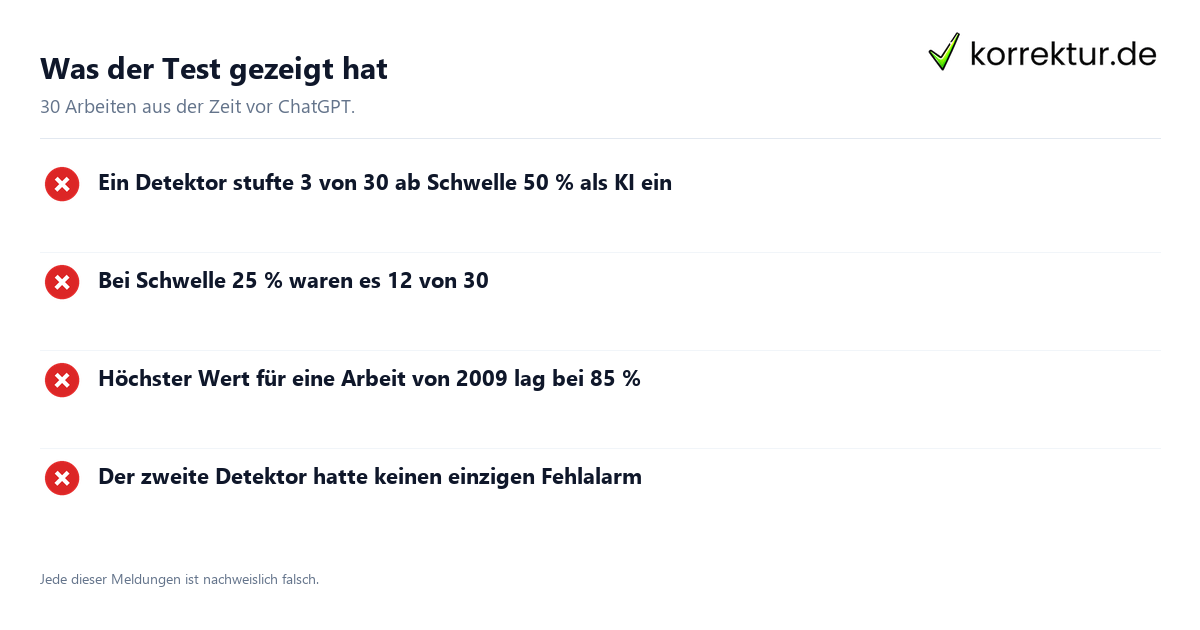
| Fehlalarm ab Schwelle 50 % | 3 von 30 | 0 von 30 |
| Fehlalarm ab Schwelle 25 % | 12 von 30 | 1 von 30 |
| KI-Texte erkannt ab 50 % | 13 von 15 | 14 von 15 |
| Mittelwert bei KI-Text | 79,6 % | 85,8 % |
Keinen einfachen Zielkonflikt zeigen unsere Daten. Bei ZeroGPT bei einer Schwelle von 50 Prozent lagen die Werte bei keinem Menschentext und bei 14 von 15 KI-Beispielen oberhalb der Schwelle. Für die Gesamtleistung beider Detektoren erlaubt das jedoch keine allgemeingültige Schlussfolgerung.
Der Extremfall: 85 Prozent für eine Arbeit aus dem Jahr 2009
KIDetektiv wies einer vor ChatGPT veröffentlichten Arbeit den höchsten Wert von 85 Prozent zu. Nach der Skala des Anbieters werden Werte über 66 Prozent als „eher generiert“ eingeordnet. Das Veröffentlichungsjahr 2009 ist ein Indiz gegen die Nutzung von ChatGPT, belegt aber nicht die Urheberschaft jeder Passage.
Bei zwölf von dreißig Arbeiten lag der Wert über 25 Prozent. Die Anbieter-Skala ordnet erst Werte um 50 Prozent als „umgeschrieben oder gemischt“ ein. Ein gleichmäßiger, sachlicher Stil kann in wissenschaftlichen Texten vorkommen; eine Ursache für einzelne Einstufungen zeigt der kleine Test jedoch nicht.
Die Auswirkungen des Schwellenwerts
Die Tools geben lediglich einen Prozentwert aus und überlassen die Interpretation dem Nutzer. Gerade darin liegt das Risiko, denn die Festlegung der Schwelle beeinflusst die Aussage maßgeblich:
- Bei 50 Prozent lagen in diesem Korpus drei von 30 Werten bei KIDetektiv oberhalb der Schwelle. Wenn die Texte menschlich verfasst sind, entspricht das einer Falsch-Positiv-Rate von 10 Prozent. In einem Kurs mit 30 Arbeiten entspräche das rechnerisch drei auffälligen Arbeiten.
- Bei 25 Prozent lagen bei KIDetektiv zwölf von 30 Werten oberhalb der Schwelle. Wenn die Texte menschlich verfasst sind, entspricht das in diesem Test einer Falsch-Positiv-Rate von 40 Prozent.
Wer ein solches Tool nutzt, sollte die gewählte Schwelle und die Testgrundlage klar benennen. Die genannten Anteile beruhen auf wenigen Beispielen und genügen nicht, um allein daraufhin Prüfungsentscheidungen zu treffen.
Was du bei einem positiven Detektorbefund tun kannst
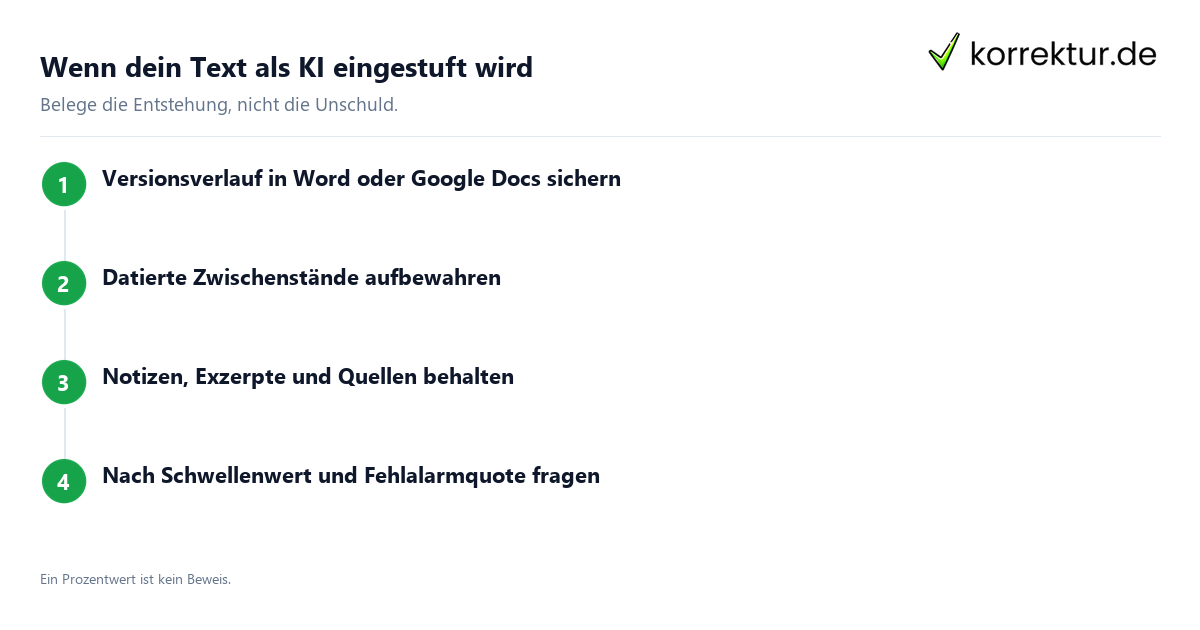
Ein hoher Detektorwert beweist die Urheberschaft eines Textes nicht ohne weitere Prüfung. Praktisch hilft es, die Entstehung der Arbeit belegen zu können:
- Versionshistorie sichern. Word und Google Docs können frühere Stände anzeigen und helfen so, die Entwicklung sichtbar zu machen.
- Zwischenstände sichern. Ein Ordner mit datierten Fassungen kann zeigen, wie der Text schrittweise gewachsen ist.
- Halte Unterlagen fest. Deine Recherchen und Notizen können den individuellen Gedankengang belegen.
- Prüfe die Grenze. Ermittle den genutzten Grenzwert und die damit verbundene Quote möglicher Fehlalarme.
Details dazu liest du auf unserer Seite zur Aussagekraft von Plagiatsprüfung und KI-Detektor.
Einschränkungen dieser Untersuchung
Vier Einschränkungen gehören dazu:
- Zwei Detektoren ersetzen keinen Marktüberblick. Die Untersuchung beschränkt sich auf zwei externe Detektoren, die zum Testzeitpunkt kostenlos und ohne Registrierung nutzbar waren; einen eigenen Scan bezogen wir nicht ein. Ein weiterer externer Kandidat ließ sich nicht bedienen, weil sein Cookie-Dialog das Eingabefeld dauerhaft verdeckte.
- 30 plus 15 Texte ergeben eine kleine Stichprobe. Daraus folgen nur eingeschränkte Rückschlüsse; allgemeingültige Raten lassen sich damit nicht ableiten.
- Die KI-Texte stammen aus einem einzigen, auf dieser Seite nicht näher benannten Sprachmodell. Andere Modelle oder nachträglich bearbeitete Texte lassen sich ohne Zusatztests nicht einschätzen.
- Den internen KI-Scan testeten wir absichtlich nicht. Eine objektive Bewertung unseres Angebots sollte von neutralen Seiten erfolgen.
Methodik
Das Mensch-Korpus besteht aus deutschen Bachelor- und Masterarbeiten, die über OAI-Schnittstellen von Hochschulen bezogen wurden. Berücksichtigt wurden ausschließlich Schriften mit einem Erscheinungsjahr bis 2020. Pro Dokument prüften wir einen zusammenhängenden Abschnitt von rund 1.600 Zeichen aus dem Hauptteil, nachdem Kopfzeilen, Fußnoten und Verzeichnisse entfernt worden waren.
Die 15 KI-Texte wurden mit einem Sprachmodell erzeugt; Modellname und Version werden auf dieser Seite nicht angegeben. Es sollte jeweils einen Auszug von rund 260 Wörtern aus dem Hauptteil einer Bachelorarbeit zu einem vorgegebenen Thema verfassen, ohne weitere Bearbeitung. Jeder Text wurde einmal durch jeden Detektor geschickt; als Grundlage der Auswertung diente jeweils der angezeigte Prozentwert.
Weiterführende Informationen: KI-Detektoren im Vergleich, Merkmale von KI-Texten, Blindtest der Korrekturprogramme sowie wissenschaftliches Fehlverhalten.