Was die univariate Statistik über eine Variable verrät
Wie die univariate Analyse Variablen zusammenfasst
Die univariate Statistik ist ein wichtiger Ausgangspunkt der Datenauswertung. Sie betrachtet jede Variable einzeln, um deren Werteverteilung zu beschreiben, bevor Zusammenhänge zwischen Variablen untersucht werden. Dieser Leitfaden zeigt, wie man eine Variable mittels Häufigkeiten, Lage- und Streuungsmaßen sowie Verteilungsanalysen beschreibt. Zudem erläutert er die Abgrenzung zu bivariaten und multivariaten Verfahren und zeigt die Umsetzung in SPSS anhand eines Beispiels.
Kostenlos herunterladen
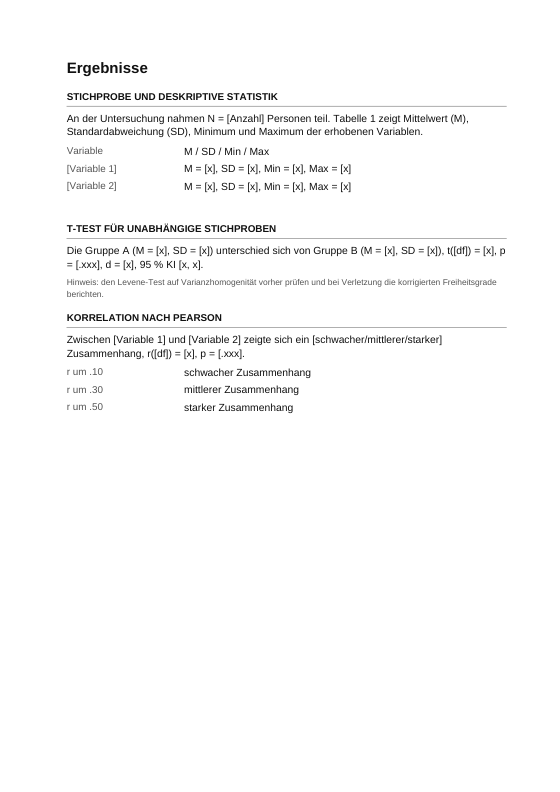
Statistik berichten: Mustersätze für den Ergebnisteil
Ergebnisblätter nach APA 7 zum Ausfüllen: deskriptive Statistik, t-Test, Korrelation, Regression, Varianzanalyse und Chi-Quadrat-Test, jeweils mit Mustersatz, Tabelle und Effektstärke. Dazu die Schreibregeln für p-Werte, Symbole und Freiheitsgrade.
Was die univariate Analyse untersucht
Die univariate Statistik konzentriert sich auf eine Variable. Statt Beziehungen zwischen Merkmalen zu prüfen, beschreibt sie die Verteilung der Werte einer einzelnen Variable: Welche Werte treten wie oft auf, wo befindet sich der Mittelpunkt und wie groß ist die Streuung? Sie gehört zur beschreibenden deskriptiven Statistik. Die Beschreibung einzelner Variablen hilft, auffällige Werte oder Verteilungsformen vor weiterführenden Analysen zu erkennen. Je nach Fragestellung kann sie Teil eines Ergebnisteils sein und die Einordnung komplexerer Analysen erleichtern.
Verteilungsform und Häufigkeiten
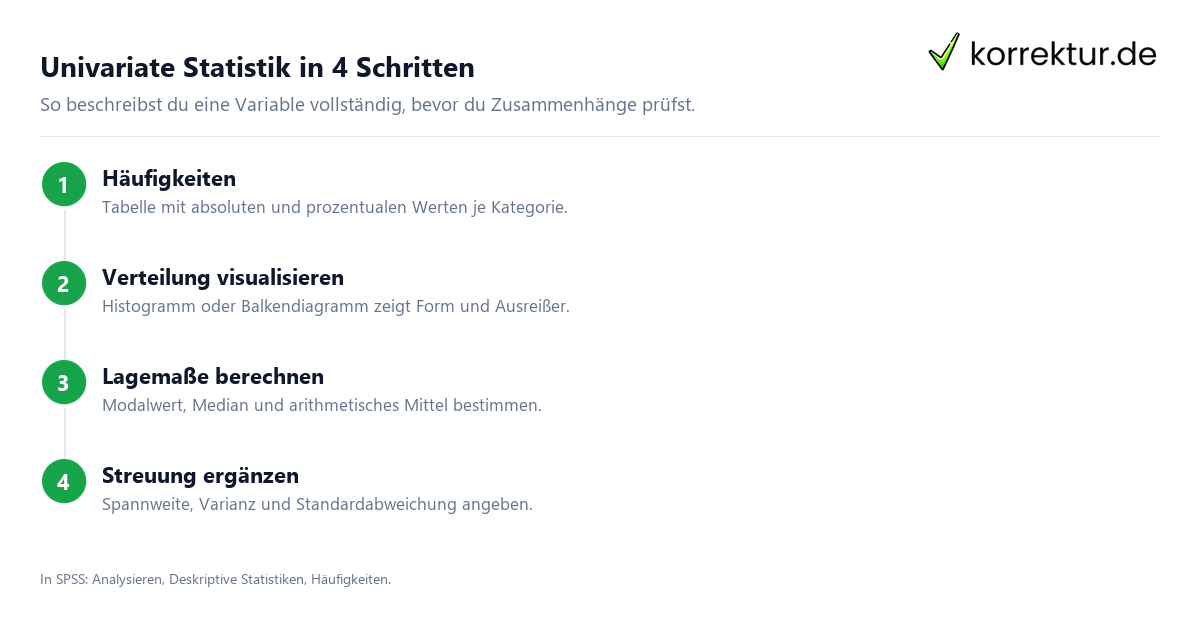
Ein möglicher erster Schritt ist die Häufigkeitsverteilung: Sie weist für Werte oder Kategorien absolute und, sofern sinnvoll, prozentuale Häufigkeiten aus. Bei kategorialen Merkmalen wie dem Studienfach kann diese Beschreibung bereits aufschlussreich sein. Nominale Daten lassen sich etwa mit Balken- oder Kreisdiagrammen, metrische Daten mit Histogrammen darstellen. Solche Grafiken können Hinweise auf Verteilungsform, Schiefe, mehrere Gipfel oder mögliche Ausreißer geben; die Befunde sollten bei Bedarf mit weiteren Prüfungen abgesichert werden. Bei vielen unterschiedlichen Werten werden metrische Daten häufig in Klassen zusammengefasst, damit das Diagramm übersichtlich bleibt. Die Klassenbreite beeinflusst, wie fein oder grob die Verteilung erscheint: Zu wenige Klassen können Strukturen verdecken, zu viele die Darstellung unübersichtlich machen.
Lage- und Streuungsmaße
Im Anschluss an die Häufigkeitsauswertung fasst man die Daten mit zentralen Kennzahlen zusammen. Lagemaße beschreiben die Lage einer Verteilung; dazu zählen Modalwert, Median und arithmetisches Mittel. Streuungsmaße beschreiben die Verteilung der Werte, beispielsweise Spannweite, Interquartilsabstand, Varianz und Standardabweichung. Die Wahl der Kennzahl richtet sich nach Skalenniveau, Verteilungsform und Fragestellung: Bei nominalen Daten ist nur der Modalwert ein Lagemaß; bei metrischen Daten können auch Mittelwert und Standardabweichung geeignet sein. Eine univariate Statistik liefert damit eine Grundlage für die weitere Analyse. Ist die Verteilung schief oder von Ausreißern geprägt, ist der Median oft aussagekräftiger als das arithmetische Mittel, da er gegenüber einzelnen extremen Werten robust ist. Daher sollte man je nach Datenlage bewusst das passende Lagemaß wählen und nicht automatisch den Mittelwert berichten. Bei metrischen Daten können Schiefe und Wölbung zusätzliche Aspekte der Verteilungsform beschreiben.
Abgrenzung: univariat, bivariat und multivariat
Die univariate Analyse untersucht eine einzelne Variable, die bivariate zwei und die multivariate mehr als zwei Variablen gleichzeitig. Analysierst du lediglich die Altersverteilung deiner Befragten, handelt es sich um eine univariate Untersuchung. Prüfst du hingegen, ob ein Zusammenhang zwischen Alter und Einkommen besteht, ist die Analyse bivariat, etwa mit einer Korrelation oder anderen Verfahren der bivariaten Statistik. Treten mehrere Einflussgrößen auf, wie etwa in einer Regression, ist die Analyse multivariat. Die Beschreibung einzelner Variablen ist häufig eine sinnvolle Vorbereitung auf weiterführende Verfahren. Welche Methode geeignet ist, hängt von Fragestellung, Skalenniveau und Datenstruktur ab: Für zwei Variablen kommen etwa Korrelationen oder Kreuztabellen, für mehrere Variablen unter anderem Regressionsverfahren infrage.

Univariate Auswertung mit Software
In SPSS erfolgt die Auswertung über den Menüpfad Analysieren, Deskriptive Statistiken, Häufigkeiten. Dort wählst du die Variable aus und aktivierst unter Statistiken die gewünschten Lage- und Streuungsmaße sowie unter Diagramme ein Histogramm oder Balkendiagramm. Für metrische Variablen bietet der Menüpunkt Deskriptive Statistiken zudem Mittelwert und Standardabweichung in einer kompakten Tabelle. Die Ausgabe kann als Grundlage für eine Tabelle in der Arbeit dienen, sollte dort jedoch einheitlich formatiert, beschriftet und inhaltlich geprüft werden. Runde Kennzahlen nachvollziehbar und gib die Anzahl der Nachkommastellen einheitlich an. Einheitliche Tabellen erleichtern den Vergleich mehrerer Variablen.
Praktisches Anwendungsbeispiel
In einem fiktiven Beispiel erhebt eine Studentin das Alter einer Gruppe von Personen. Sie erstellt zunächst eine Häufigkeitstabelle und ein Histogramm, um die Verteilung der Alterswerte zu beschreiben. Anschließend berechnet sie Mittelwert, Median und Standardabweichung. Die univariate Statistik fasst damit die Variable Alter zusammen, bevor die Studentin sie mit anderen Merkmalen in Beziehung setzt. Erst danach kann sie beispielsweise untersuchen, ob Alter und Studienfach zusammenhängen. Die Beschreibung der einzelnen Variable dokumentiert, welche Kennzahlen und Darstellungen den weiteren Analysen zugrunde liegen.
Wer jede Variable einzeln auswertet, kann besser einordnen, was der Datensatz verrät. Weitere Themen sind bivariate und deskriptive Analysen sowie der Überblick zu statistischen Auswertungsverfahren.