Inferenzstatistik in SPSS: Signifikanztests und p-Wert anwenden
Warum die Inferenzstatistik über die Stichprobe hinausgeht
Die Inferenzstatistik beantwortet die zentrale Frage jeder empirischen Arbeit: Lässt sich das Ergebnis einer Stichprobe auf die gesamte Grundgesamtheit übertragen? Von der reinen Datenerfassung bis zur statistischen Modellierung gibt es viele Schritte, die man korrekt anwenden muss. Während die beschreibende Statistik nur die erhobenen Daten zusammenfasst, zieht die schließende Statistik daraus verallgemeinernde Schlüsse. Dieser Ratgeber erklärt, was dieses Teilgebiet leistet, beleuchtet den Unterschied zur deskriptiven Statistik sowie das Prinzip von Signifikanztests und p-Wert und zeigt die Auswertung in SPSS an einem konkreten Beispiel.
Kostenlos herunterladen
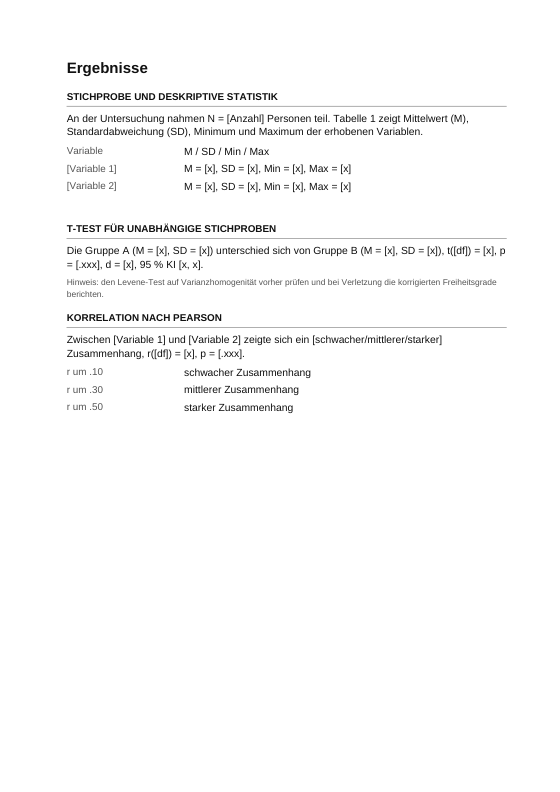
Statistik berichten: Mustersätze für den Ergebnisteil
Ergebnisblätter nach APA 7 zum Ausfüllen: deskriptive Statistik, t-Test, Korrelation, Regression, Varianzanalyse und Chi-Quadrat-Test, jeweils mit Mustersatz, Tabelle und Effektstärke. Dazu die Schreibregeln für p-Werte, Symbole und Freiheitsgrade.
Typische Kennzeichen der inferenziellen Statistik
Die Inferenzstatistik wird auch schließende oder induktive Statistik genannt. Sie nutzt Daten einer Stichprobe und ein statistisches Modell, um Aussagen über eine größere Grundgesamtheit zu prüfen. Ob eine Verallgemeinerung tragfähig ist, hängt unter anderem von Studiendesign, Stichprobenziehung und Modellannahmen ab. Im Unterschied zur Beschreibung der Stichprobe bewertet sie, wie gut die Daten mit einem spezifizierten Modell, etwa einer Nullhypothese, vereinbar sind. Zu ihren Methoden gehören Konfidenzintervalle, Signifikanztests und Regressionsanalysen. Diese Verfahren können die Unsicherheit einer Schätzung oder eines Tests quantifizieren, ersetzen aber keine passende Datenerhebung.
Wichtige Unterschiede zur deskriptiven Statistik
deskriptive Statistik fasst die vorhandenen Daten mithilfe von Mittelwert, Standardabweichung, Häufigkeiten und Grafiken zusammen. Die schließende Statistik prüft unter geeigneten Voraussetzungen, was eine Stichprobe über eine Grundgesamtheit aussagen kann. Beide Teilgebiete ergänzen sich: Zunächst beschreibt man die Daten sorgfältig, danach beurteilt man, ob und in welchem Umfang sich Erkenntnisse übertragen lassen. Die reine Beschreibung stützt keine Verallgemeinerung; maßgeblich sind außerdem Studiendesign, Stichprobenziehung und Modellannahmen. Eine klare Gliederung beider Phasen im Bericht verbessert die Nachvollziehbarkeit der Ergebnisse.
Signifikanztests und der p-Wert
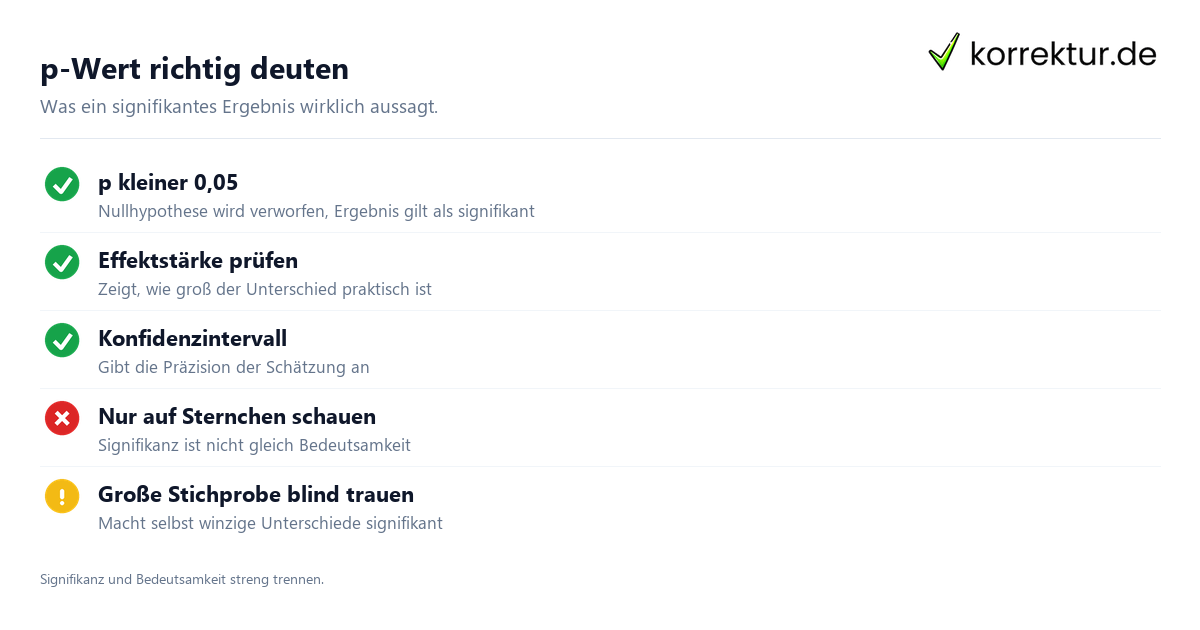
Zu den Kernverfahren der schließenden Statistik gehört der Signifikanztest. Er untersucht eine Nullhypothese, die je nach Kontext zum Beispiel keinen Unterschied oder keinen Zusammenhang annimmt. Der p-Wert gibt innerhalb des verwendeten Modells die Wahrscheinlichkeit an, ein mindestens so extremes Resultat wie die tatsächliche Beobachtung zu erzielen. Liegt der p-Wert unter einem vorab festgelegten Signifikanzniveau, häufig 0,05, wird das Ergebnis nach dieser Entscheidungsregel als statistisch signifikant bezeichnet. Die Schritte von der Hypothesenaufstellung über die Teststatistik bis zur Schlussfolgerung orientieren sich am klassischen Hypothesentest. Ergänzend liefern Effektstärken sowie Konfidenzintervalle Hinweise auf Umfang und Genauigkeit des geschätzten Effekts.
Den p-Wert richtig deuten
Der p-Wert wird häufig falsch interpretiert. Er ist nicht die Wahrscheinlichkeit, dass die Nullhypothese wahr ist, und kein Maß für die Stärke eines Effekts. Ein kleiner p-Wert zeigt, dass die Daten mit dem zugrunde gelegten statistischen Modell weniger vereinbar sind. Deshalb sollten neben der Signifikanz auch eine Effektstärke und ein Konfidenzintervall berichtet werden, sofern sie für das Verfahren verfügbar und sinnvoll sind. Ein statistisch signifikantes Ergebnis kann bei geringer Effektstärke praktisch wenig bedeutsam sein. Signifikanz und praktische Relevanz sind daher getrennt zu beurteilen. Eine große Stichprobe kann auch kleine Unterschiede statistisch signifikant machen; die Effektstärke hilft bei deren Einordnung.
Inferenzstatistik in SPSS rechnen
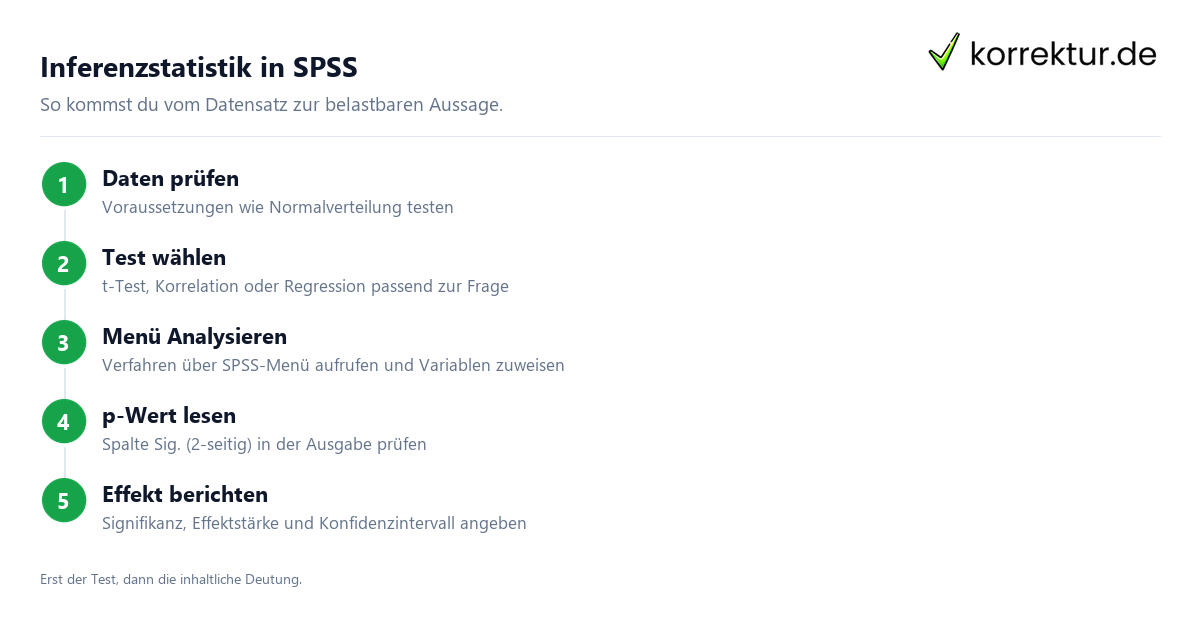
Praktisch jede Signifikanzprüfung startest du in SPSS über das Menü Analysieren, etwa den t-Test im Abschnitt Mittelwerte vergleichen oder Korrelationen unter Korrelation. Das Programm zeigt den p-Wert in der Ausgabe üblicherweise in der Spalte Sig. oder Signifikanz (2-seitig) an. Dadurch lässt sich die inferenzielle Statistik mit wenigen Klicks durchführen; entscheidend sind jedoch die korrekte Auswahl des Verfahrens und die klare Interpretation der Ergebnisse. Der SPSS-Hub fasst relevante Methoden zusammen, etwa für eine bivariate Auswertung zweier Variablen. Bevor du testest, prüfst du besser die Voraussetzungen, etwa Normalverteilung oder Varianzhomogenität, anhand geeigneter Kennzahlen. Werden diese verletzt, nutzt man robustere oder verteilungsfreie Ansätze. Zwar vereinfachen Standardausgaben diese Kontrolle, doch ersetzen sie nicht die fachliche Einschätzung, ob der jeweilige Test zur Fragestellung passt.
Ein Praxisbeispiel inklusive Voraussetzungen und Einschränkungen
Eine Studentin vergleicht die Prüfungsergebnisse zweier Lerngruppen mit jeweils 30 Personen. In der Stichprobe erzielt Gruppe A im Mittel 0,4 Notenpunkte mehr. Angenommen, die Gruppen und Messungen erfüllen die Voraussetzungen eines geeigneten t-Tests und die Stichprobe erlaubt einen Bezug zur interessierenden Grundgesamtheit, ergibt ein zweiseitiger t-Test in SPSS einen p-Wert von 0,03. Bei einem vorab gewählten Signifikanzniveau von 0,05 ist das Ergebnis nach dieser Regel statistisch signifikant. Der p-Wert allein belegt jedoch weder die Größe noch die praktische Bedeutung des Unterschieds und rechtfertigt keine uneingeschränkte Verallgemeinerung. Dafür sind unter anderem Effektstärke, Konfidenzintervall, Studiendesign und Stichprobenziehung zu berücksichtigen. Ein signifikanter Test beweist nichts endgültig, sondern beschreibt die Vereinbarkeit der Daten mit dem zugrunde gelegten Modell. Replikationen und transparente Berichte können die Evidenz für einen Befund stärken.
Weitere Statistik-Themen: deskriptive Statistik, bivariate Statistik sowie Statistik und SPSS.